


此前 Ransea 报道了 Mac Studio 512GB 版本的定价,最高配置超过 12,000 美元。这次 Tom’s Hardware 带来了 M5 Ultra 芯片在本地 AI 推理中的详细基准测试数据,重点对比了其与 Nvidia DGX Spark 的性能与能效。
要点速览
M5 Ultra Mac Studio 在 AgentPerf-Local 测试中,使用 Qwen 3.8 27B 模型时,完成速度不到单台 DGX Spark 的一半,且任务能耗低约 16%。其能效延迟乘积(EDP)仅为 Spark 的一半,显示出极高的能效优势。
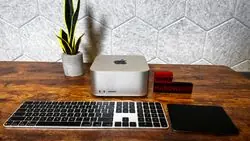
关键参数
| 项目 | 参数 |
|---|---|
| 芯片 | Apple M5 Ultra (36 核 CPU, 80 核 GPU) |
| 内存 | 最高 512GB 统一内存 |
| 内存带宽 | 1.2 TB/s |
| 对比对象 | Dell Pro Precision GB10 (Nvidia GB10/Spark) |
| 测试模型 | Qwen 3.8 27B, DeepSeek V4.1 Flash, GLM 5.3 Flash |
价格与上市
- M5 Ultra Mac Studio (256GB/1TB):约 12,300 美元起(约 82,000 元)
- Dell Pro Precision GB10 (4TB SSD):约 10,000 美元(约 66,700 元)
- 双 Spark 集群:约 15,000 至 20,000 美元(约 100,000 至 133,333 元)
- 预计发货周期:13 至 15 周
媒体评价
Tom’s Hardware 指出,虽然 M5 Ultra 在密集模型和 llama.cpp 后端下表现优异,但在运行 DeepSeek V4.1 Flash 等超大模型时,受限于内存容量,需依赖双 Spark 集群。目前 TensorFold 引擎能显著提升 GLM 5.3 Flash 的性能,但 DeepSeek 的优化支持仍在开发中。
个人工作室值得为 M5 Ultra 的 AI 性能买单吗?
对于个人创作者和家庭工作室,M5 Ultra Mac Studio 最大的价值在于“单机电力与空间效率”。在运行 Qwen 3.8 等中等规模模型时,它比单台 DGX Spark 快两倍且更省电,无需复杂的集群配置。
然而,若需运行 DeepSeek V4.1 Flash 等超大模型,单台 Mac Studio 受限于内存,速度不如双 Spark 集群。这意味着用户需在“开箱即用的便捷”与“极致算力的可扩展性”之间做选择。
适合谁: 追求静音、低功耗且主要运行中等规模本地模型的用户。 不适合谁: 需要频繁微调或运行超大参数模型,且愿意折腾集群软件生态的用户。冷静的说,对于大多数的创作者来说,这两套设备都太贵了,基本的文本类的工作,一般人也用不着很大的大模型,QWEN3.6 27B级别的MOE模型一般也够用了;对于视频生成来说,M5 Ultra Mac Studio的解码能力又显得没有性价比;具体选择还得看自己的预算和需求。


