


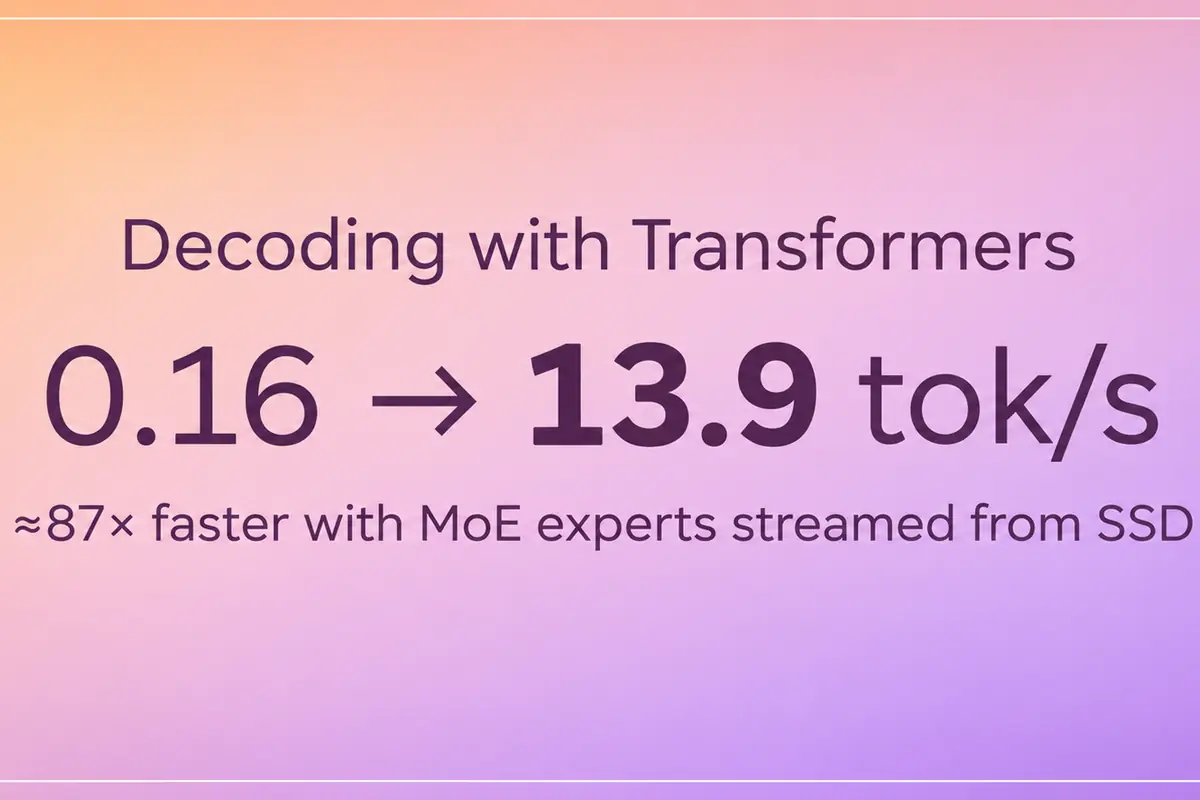
Hugging Face 官方博客于 2026 年 11 月 18 日发布文章,宣布通过改进 Transformers 库,实现了将 180B 参数的混合专家(MoE)模型直接通过 SSD 流式传输到 GPU 的功能,在 32GB 统一内存的 MacBook 上运行速度仅比专用引擎 Strata 慢 6%。
要点速览
- 突破内存限制:通过流式传输技术,180B 参数的 MoE 模型(Qwen3.8-Flash-Next)无需将所有专家权重加载到内存,而是按需从 SSD 读取,使得 32GB 内存的设备也能运行超大模型。
- 性能接近专用引擎:在 MacBook M5(32GB)上,优化后的 Transformers 实现解码速度达到约 14 tok/s,与专为 MoE 设计的推理引擎 Strata(14.8 tok/s)差距缩小至 6%。
- 技术核心是“专家池”:项目将缓存转化为“槽位池”,利用 `grouped_mm` 内核直接运行,无需自定义专家矩阵乘法,从而大幅减少 Python 循环开销。
- 对比其他引擎:在 180B 模型上,该方法在专家无法完全放入 RAM 时表现更优。此前在较小模型 Qwen3.6-35B-A3B 的测试中,vLLM 解码速度仅为 20.1 tok/s,而 Transformers 默认加速库 Accelerate 仅能跑 0.16 tok/s,显示出流式传输在大数据量下的优势。
- 适用场景:适合拥有大参数模型但显存/内存有限的个人用户,特别是使用 Apple Silicon Mac 或单张消费级显卡(如 RTX 4090)的 Maker。
关键参数
| 项目 | 参数 |
|---|---|
| 测试模型 | Qwen3.8-Flash-Next (180B 参数) |
| 测试设备 | MacBook M5 (32GB 统一内存) |
| 量化方式 | 专家 3-bit, 密集层 8-bit |
| 解码速度 (Transformers) | ~14 tok/s |
| 解码速度 (Strata) | 14.8 tok/s |
| 预填充速度 (4K prompt) | 228 tok/s |
| 内存占用峰值 | ~25.4 GiB (6K prompt) |
价格与上市
- 软件:Hugging Face Transformers 库(PR #50717)及配套包 `moe-expert-streaming`
- 价格:免费开源
- 上市时间:2026 年 11 月 18 日随博客发布,代码已上传至 Hugging Face Space
RANSEA VIEW
一个读者会问的问题
这对个人和家庭工作室意味着什么?
这意味着你不再需要昂贵的 128GB 内存 Mac Studio 或双路 GPU 工作站来运行 180B 级别的顶级模型。对于拥有 MacBook Pro(32GB)或单张 RTX 4090 的用户,通过 SSD 流式传输专家权重,可以以接近专用引擎的速度运行超大模型。
值不值得?
对于经常需要在本地运行大型代码助手或进行长文档分析的个人开发者,这项技术极具价值。它解决了“模型太大装不下”的痛点,且无需复杂的 C++ 扩展,仅通过 Python 和 Metal 内核即可实现。虽然比专用引擎略慢,但在日常交互中感知差异不大。
适合谁?
适合使用 Apple Silicon Mac 或 Linux/Windows 单 GPU 环境,且希望本地运行 100B+ 参数模型的独立创作者、程序员和数据分析师。不适合对延迟要求极高(如实时语音对话)或显存充足无需流式传输的用户。


