


Meta AI 于 11 月 9 日(北京时间 11 月 10 日)正式发布 Muse Ember,这是其目前最小且最高效的 AI 模型,旨在填补轻量级推理模型的空白。
要点速览
Muse Ember 定位为 Claude Haiku 5.5 和 GPT-6 Luna 的直接竞争对手,专注于 AI Agent 全天重复执行的任务,如工具调用、编码子任务、路由、提取和长文档解析。
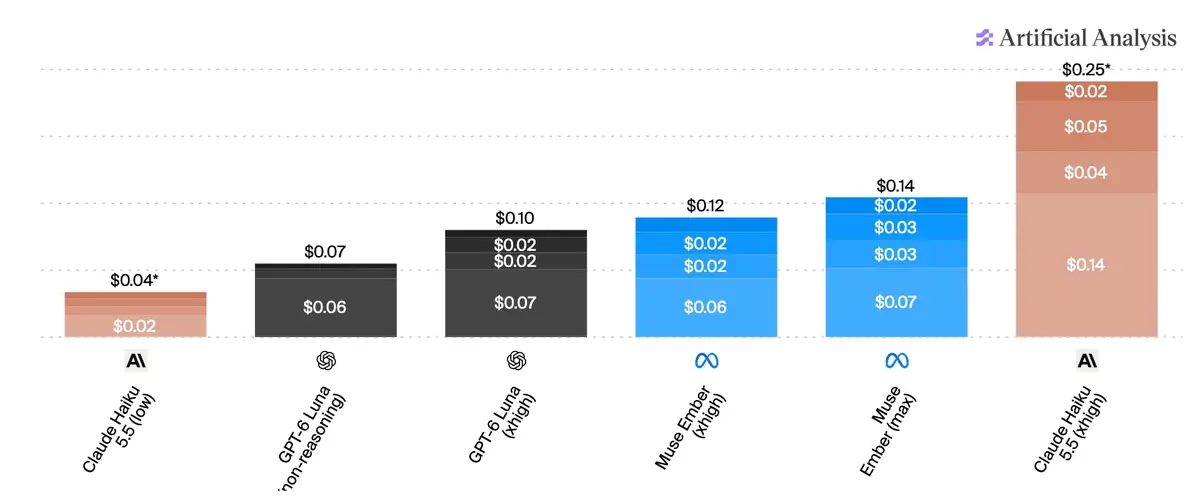
Meta 宣称,在 Artificial Analysis 的测试中,Muse Ember 位于“效率前沿”(Pareto line),意味着在相同任务成本下,没有模型能提供更高的智能评分。其单次任务成本约为 0.14 美元,而同系列的 Muse Spark 1.3 成本为 2.39 美元,两者智能评分接近(36 对 37)。
关键参数
| 项目 | 参数 |
|---|---|
| 模型名称 | Muse Ember 1.0 |
| 主要用途 | Agent 工具调用、编码子任务、路由、数据提取 |
| 上下文窗口 | 最高支持 1,000,000 tokens |
| 推理等级 | 6 级(minimal, low, medium, high, xhigh, max) |
| 多模态支持 | 文本、图像、音频、视频 |

价格与上市
Muse Ember 现已通过 Meta Model API 和 Muse Code 开放访问。其定价策略与 GPT-6 Luna 和 Claude Haiku 5.5 在短提示词下保持一致,但在长上下文场景下略有不同:
- 短提示词(≤200k tokens): 输入 0.10 美元/百万 tokens,缓存输入 0.004 美元/百万 tokens,输出 0.50 美元/百万 tokens。
- 长提示词(>200k tokens): 输入 0.30 美元/百万 tokens,缓存输入 0.012 美元/百万 tokens,输出 1.50 美元/百万 tokens。
作为对比,GPT-6 Luna 在超过 272k tokens 后输入价格为 0.20 美元,Haiku 5.5 在超过 100k tokens 后输入价格为 0.50 美元。
媒体评价
Simon Willison 指出: Muse Ember 的性价比在于其位于 Artificial Analysis 的效率前沿线上。虽然其推理等级(从 minimal 到 max)与视觉输出质量并不完全线性对应,但在生成 SVG 等任务的测试中,其质量可与价格高出 40 倍的 Muse Wonder 相媲美。
The Decoder 报道: 在 Meta 的自有测试中,Muse Ember 大多领先。但在 FrontierCode 2.0-AA 的真实编码任务中,Claude Haiku 5.5 以 34.9% 的得分优于 Muse Ember 的 27.2%。这表明 Ember 在通用 Agent 任务上表现优异,但在纯代码生成上略逊于竞品。
个人开发者该选它还是 Haiku/Luna?
对于独立创作者和小型工作室,Muse Ember 的核心价值在于降低 Agent 自动化工作流的成本。如果你正在构建基于 AI Agent 的工具链(例如自动处理邮件、解析长文档、调用 API 或执行小型代码片段),Ember 的高性价比和百万级上下文窗口使其成为极佳的底层引擎。
值得注意的细节:
- 长文本优势: 相比 Haiku 5.5 的 100k 限制,Ember 支持 1M tokens,适合处理长篇技术文档或代码库。
- 推理等级陷阱: 测试显示,提高推理等级并不总是带来更好的视觉或结构化输出,建议根据任务类型微调推理等级以平衡速度与成本。
- 编码短板: 如果主要用途是纯代码生成,Claude Haiku 5.5 目前仍略胜一筹;但如果是“代码+工具调用”的混合任务,Ember 更具成本优势。
对于预算敏感且需要高频调用 API 的 Maker,Muse Ember 是一个值得接入测试的新选项。


