


据 ComputerBase 报道,Nvidia 于 2021 年发布的挖矿显卡 CMP 170HX,经开发者 Kate 的硬件改造后,可解锁全部 80GB HBM2e 显存及约 120 个计算单元,性能超越原版 A100。
要点速览
- 显存全解锁: 10 张测试样张中有 9 张成功解锁全部 80GB 显存,仅 1 张为 64GB。此前通过软件工具 cmpunlocker 最多仅能解锁 64GB。
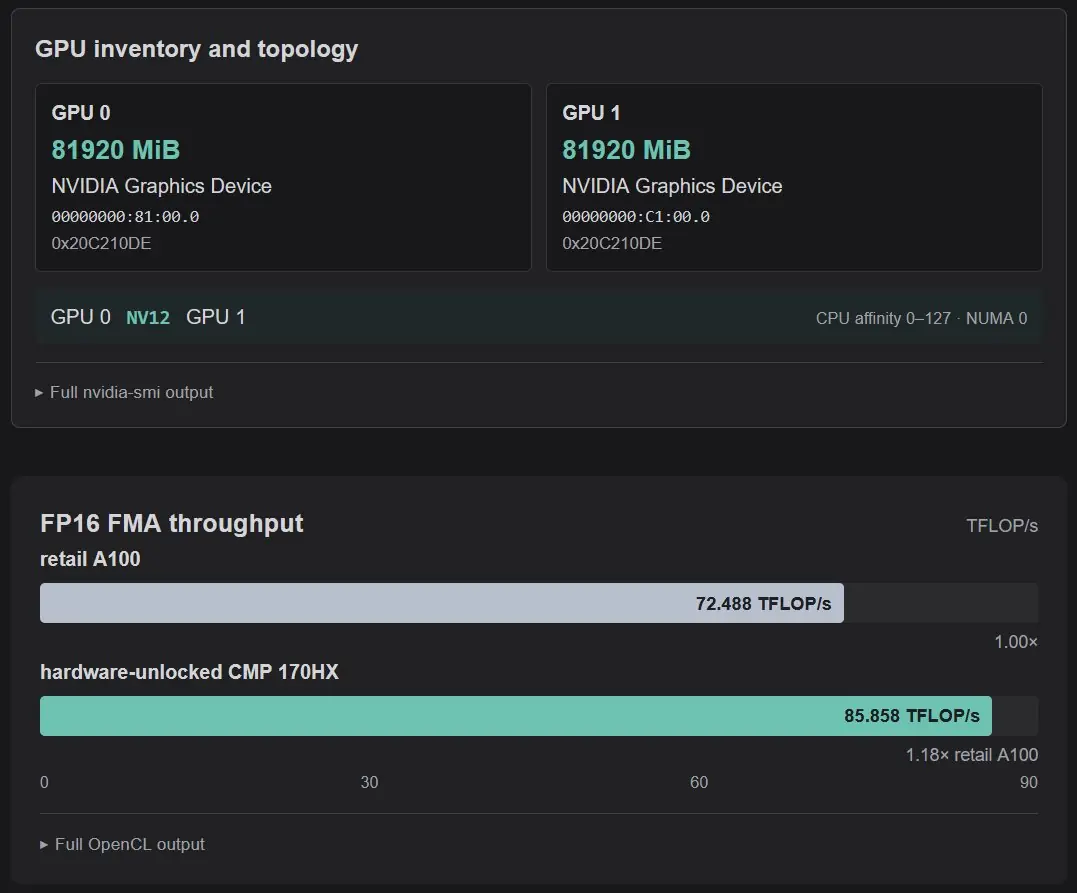
- 算力大幅提升: 激活了约 120 至 126 个流多处理器(SMs),相比出厂设定的 70 个 SMs,算力提升约 80%。FP16 测试达到 85.9 TFLOPS,比软件解锁版高出约 71%。
- 硬件改造原理: 利用 STM32 微控制器产生电压脉冲,暂时绕过 GA100 芯片的 eFuse 控制器,从而解除对显存和计算单元的硬件限制。
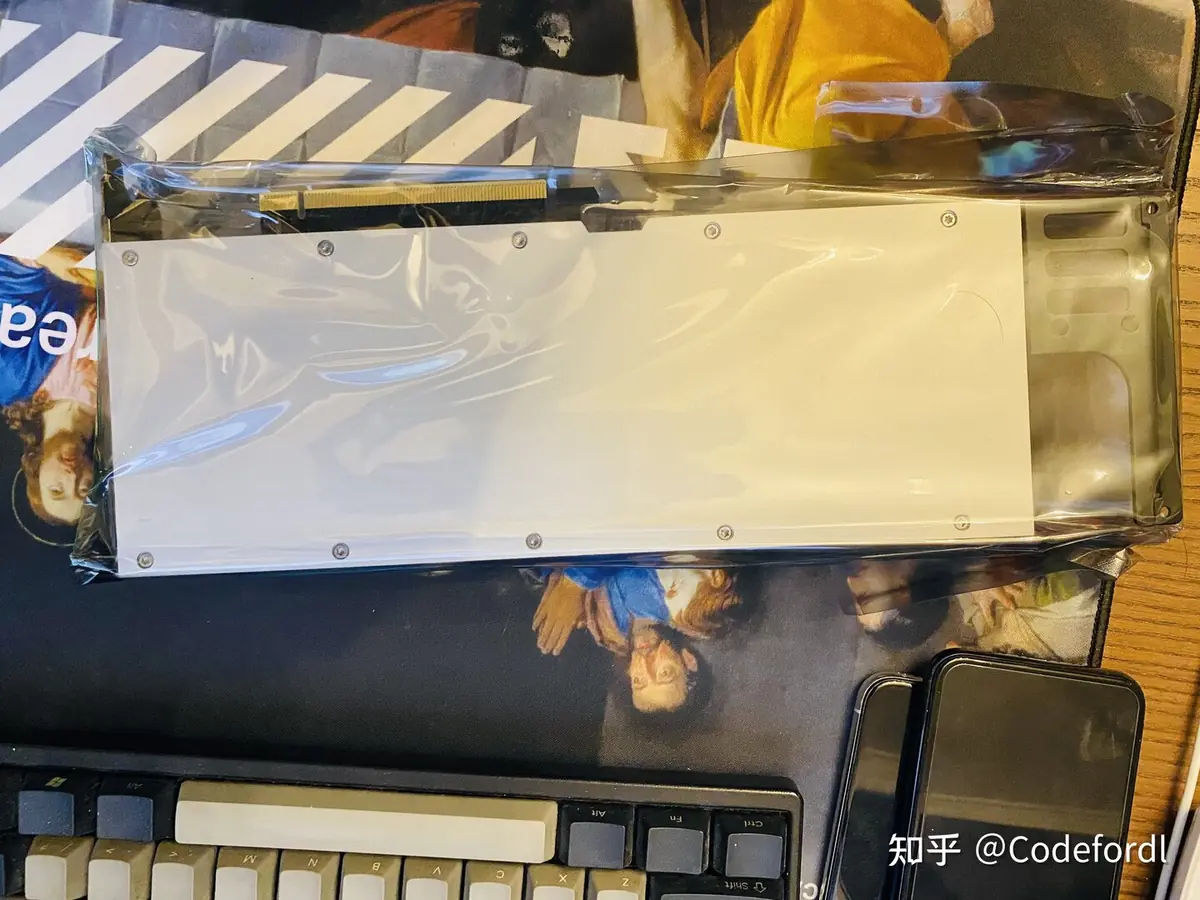
芯片背景: CMP 170HX 内部搭载的是原本用于专业级 A100 的 GA100 图形处理器。Nvidia 采用 Binning 策略,将部分存在瑕疵或为区分产品层级而禁用的芯片用于挖矿卡。该卡出厂时仅激活了 70 个 SMs 和 8GB 显存,但物理上拥有完整的 128 个 SMs 和 80GB 显存容量。
解锁细节: 开发者 Kate 开发的硬件解锁工具需要焊接在显卡上,通过制造电压跌落来重置 eFuse 状态。这一过程需要 1 到 48 小时的尝试,成功后限制为永久性。若操作失误,可能导致显卡报废。
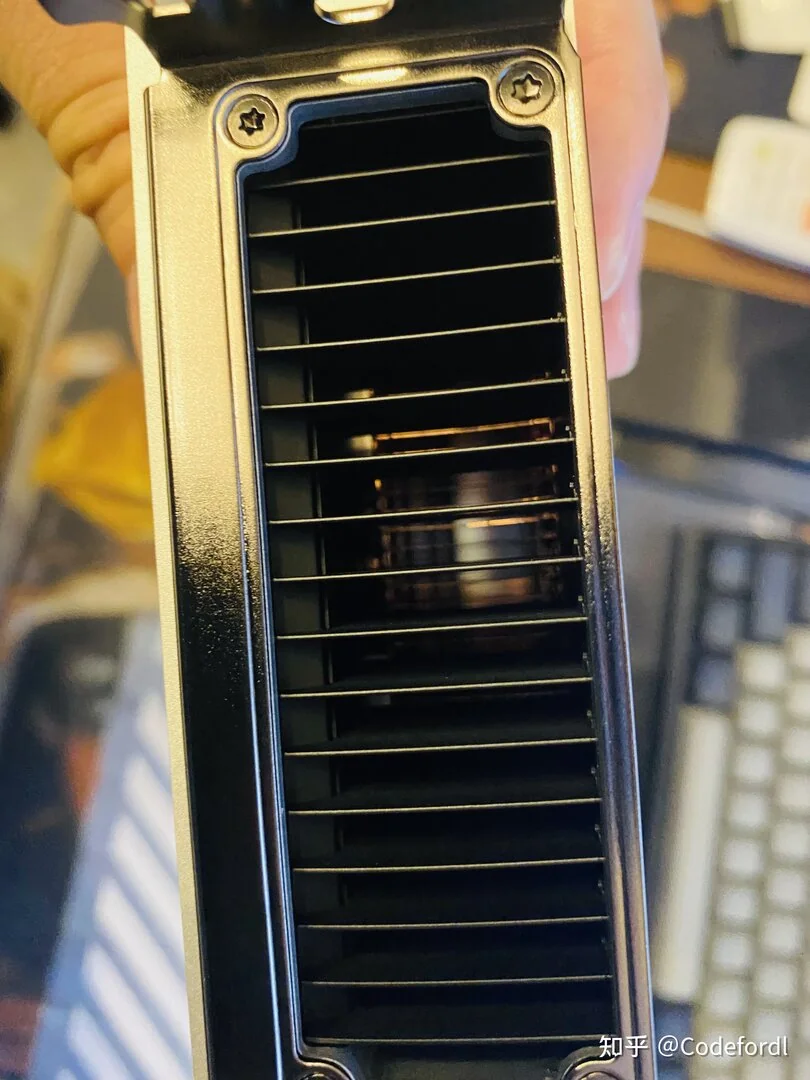
除了显存和核心算力,解锁还恢复了 PCIe 4.0 16 通道支持及 NVLink 功能,允许多卡互联。理论上还可启用 ECC 内存校验、多实例 GPU(MIG)和视频解码器,但后者尚未在实测中验证。
关键参数
| 项目 | 参数 |
|---|---|
| 核心架构 | GA100 (Ampere) |
| 出厂显存 | 8 GB HBM2e |
| 解锁后显存 | 80 GB HBM2e |
| 出厂计算单元 | 70 SMs |
| 解锁后计算单元 | 120-126 SMs |
| FP16 算力 (解锁后) | 85.9 TFLOPS |
| FP16 算力 (软件解锁) | 50.1 TFLOPS |
| FP16 算力 (A100 80GB) | 72.5 TFLOPS |
| 接口 | PCIe 4.0 x16 |
| 额外功能 | NVLink, ECC (理论支持) |
| 散热方式 | 被动散热 |
| 视频输出 | 无 |
性能对比: 在 OpenCL FP16 基准测试中,硬件解锁后的 CMP 170HX 以 85.9 TFLOPS 的成绩超越了标准版 A100 的 72.5 TFLOPS。相比之下,仅通过软件解锁的 CMP 170HX 得分为 50.1 TFLOPS。这意味着硬件改造带来的性能增益远超软件修改。
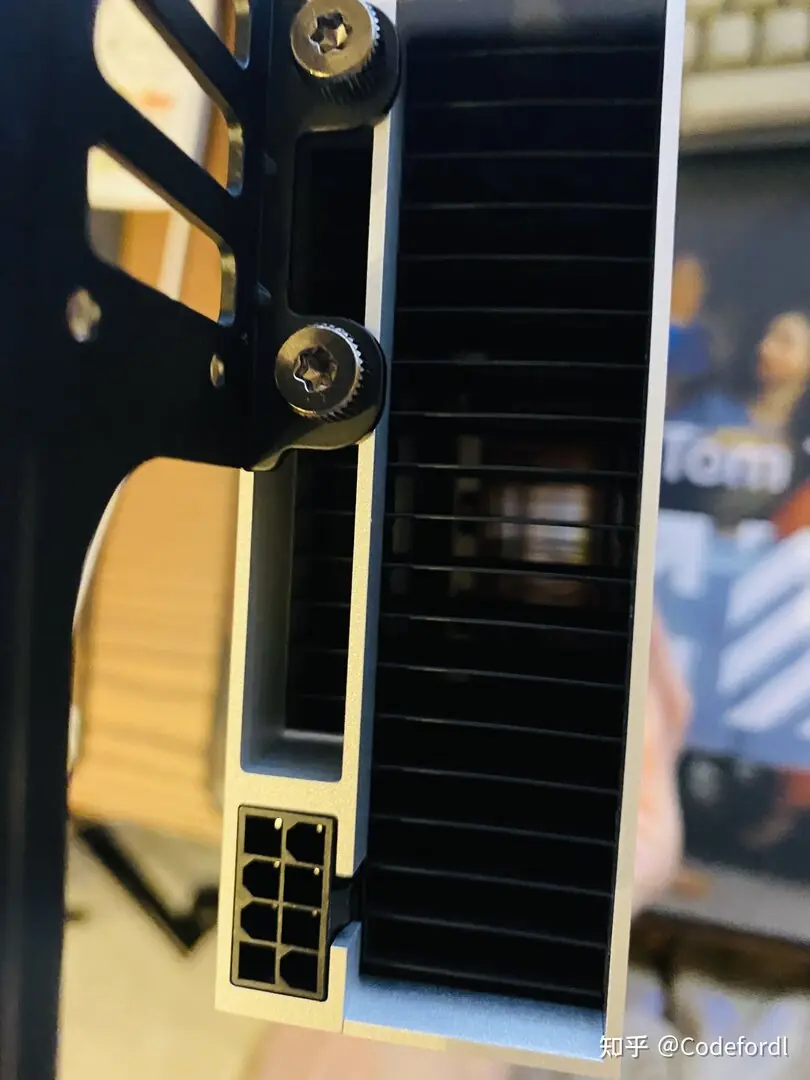
物理特性: 该卡没有视频输出接口,专为挖矿设计,采用被动散热,需要机箱拥有良好的气流。这使得它在静音要求高或无风扇需求的工作室环境中具有独特优势,但也限制了其作为日常显示显卡的用途。
价格与上市
- 首发价格: 2021 年上市时售价超过 5,000 欧元(约 39,500 元)。
- 当前二手价格: 官方尚未公布,市场二手价格随显存解锁成功率波动,通常远低于首发价。
- 解锁工具: 需自行购买 STM32 微控制器及外围元件焊接,成本较低,但需要一定的电子焊接技能。
媒体评价
ComputerBase 指出,CMP 170HX 的硬件解锁不仅释放了被禁用的显存,还大幅提升了计算单元的数量。开发者 Kate 通过电压脉冲技术,成功绕过了 GA100 芯片的 eFuse 限制。测试显示,解锁后的 FP16 算力达到 85.9 TFLOPS,比软件解锁版高出约 71%,甚至超越了标准版 A100 的 72.5 TFLOPS。这一突破使得这款曾经的挖矿卡成为本地运行大型语言模型(LLM)的高性价比选择。
一个读者会问的问题
这对个人和家庭工作室意味着什么?
对于独立创作者、3D 打印工作室或小型 AI 爱好者而言,CMP 170HX 的硬件解锁提供了一条极具性价比的路径,以较低成本获得 80GB 的大显存。在本地运行大型语言模型(LLM)、Stable Diffusion XL 或进行高分辨率 3D 渲染时,显存容量往往比核心算力更关键。80GB HBM2e 显存允许加载参数量巨大的模型,而无需依赖云算力。
值不值得、适合谁?
值得动手的用户是那些具备基础焊接能力、追求极致性价比且对噪音敏感(被动散热)的用户。它适合用于 AI 推理服务器、离线数据处理或作为 3D 打印切片集群的加速卡。不适合需要视频输出、追求即插即用或焊接技术较差的用户。考虑到解锁成功率高达 90%,这是一次风险可控的高回报投资。


