


〈阿里巴巴〉官方宣布,阿里巴巴于2026年11月16日正式发布新一代基座大模型Qwen4-Max。该模型采用全新混合架构,总参数达2.4万亿,激活参数仅710亿,在保持百万上下文窗口和原生视觉能力的同时,将单任务平均成本降低约60%。
要点速览
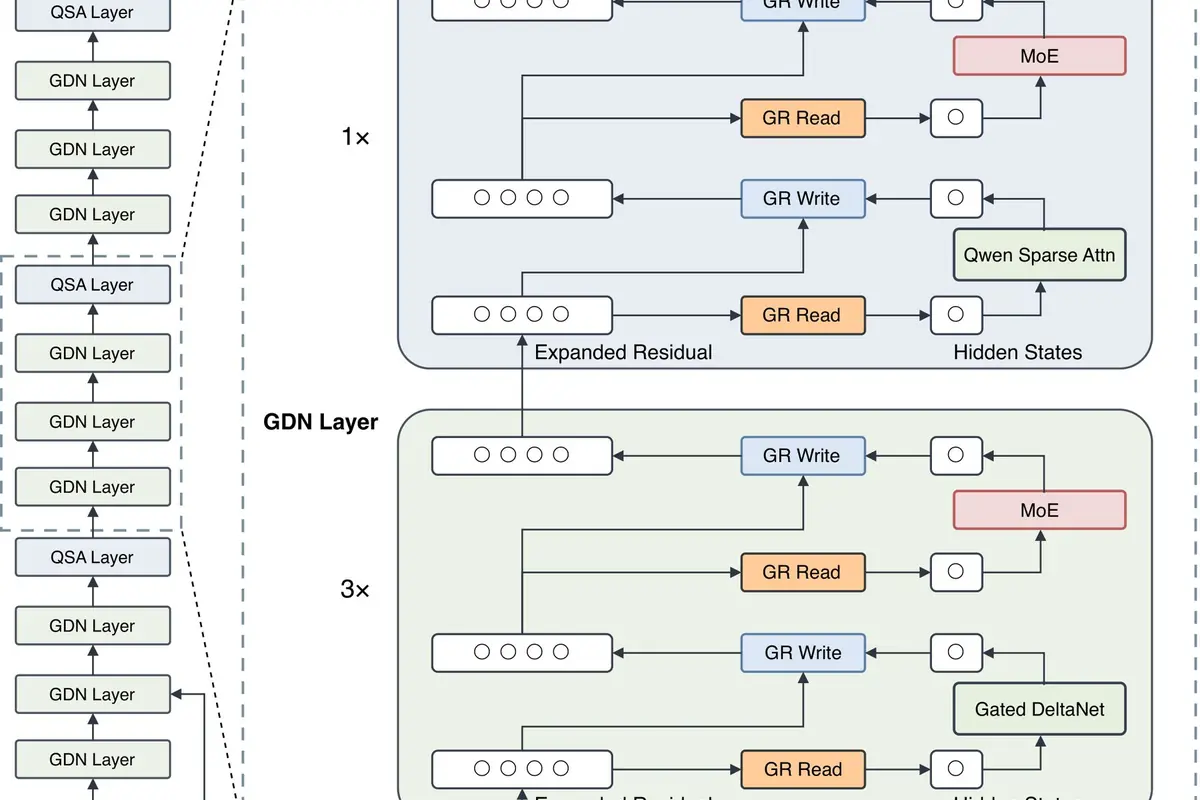
- 架构革新:Qwen4-Max采用基于Qwen稀疏注意力(QSA)的混合MoE架构,结合三层上下文压缩与四层动态门控,大幅降低长文本处理算力消耗。
- 成本大幅下降:API输入价格为1.50美元/百万Token,输出为4.50美元/百万Token,较上代降低25%。缓存命中价格仅为0.075美元,单任务平均成本从4.43美元降至1.67美元。
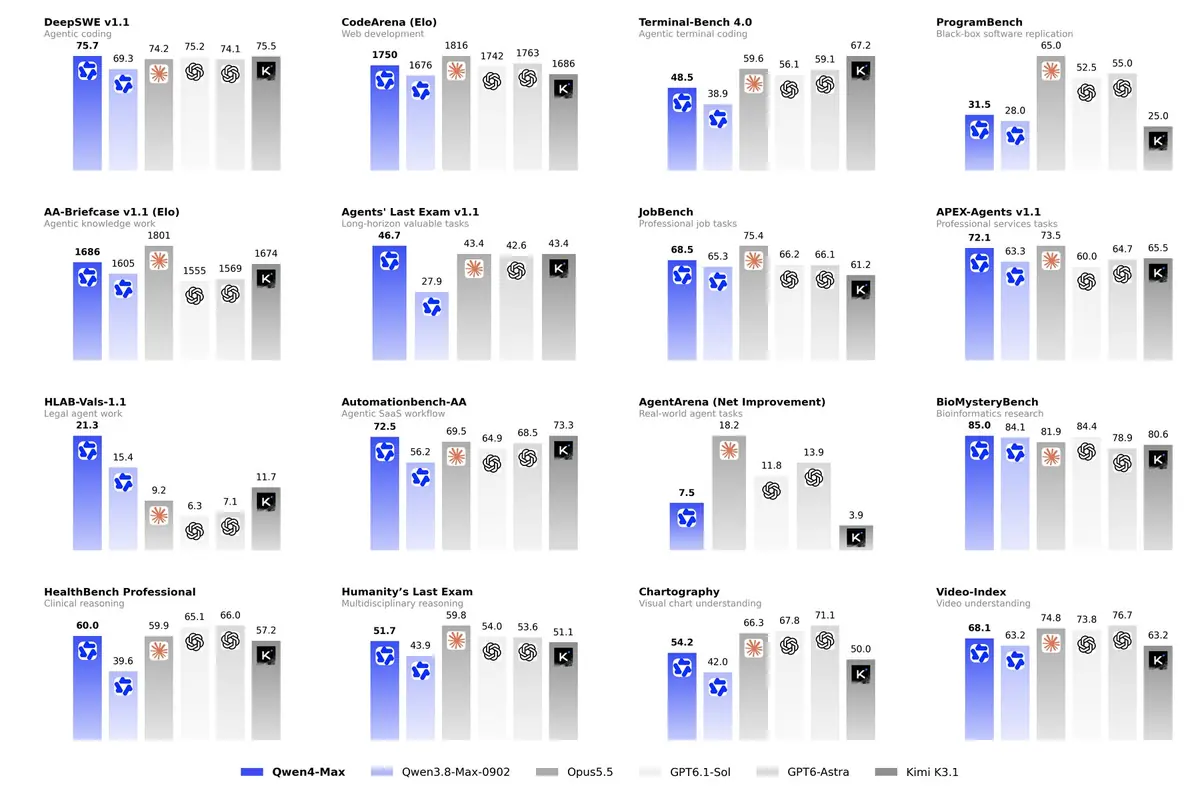
- 智能体能力进阶:引入“Live Delivery”持续交付机制,用户可在长周期任务中随时介入调整。在Agents’ Last Exam中得分46.7,位居前列。
- 3D与游戏开发:原生支持Blender及Unity、Unreal Engine等引擎,可从单一提示词生成可玩游戏及3D模型,适用于3D打印与独立游戏开发。
- 科学发现突破:在材料科学领域,模型自主运行48小时,完成4轮“设计-合成-测试”闭环,合成新型数据中心冷却液;在药物发现中,优化分子结合亲和力提升3.6倍。
- 基准测试表现:在Artificial Analysis Intelligence Index中得43分,仅次于Kimi K3.1 Pro(46分)。在CodeArena前端编程榜中位列全球第6,刷新中国模型最好成绩。
关键参数
| 项目 | 参数 |
|---|---|
| 总参数量 | 2.4万亿 |
| 激活参数量 | 710亿(每Token) |
| 上下文窗口 | 100万Token |
| 输入价格 | 1.50美元/百万Token(约10元) |
| 输出价格 | 4.50美元/百万Token(约30元) |
| 缓存命中价格 | 0.075美元/百万Token(约0.5元) |
| 原生模态 | 文本、图像、视频输入,文本输出 |
| 架构类型 | 混合MoE + N-gram Embedding(3280亿参数) |
价格与上市
- API服务:已上线QwenCloud,输入1.50美元/百万Token,输出4.50美元/百万Token,缓存0.075美元/百万Token。
- 应用体验:用户可通过千问AI平台、千问办公、Qoder、QwenStudio及千问APP直接体验。
- 开源计划:Qwen4系列中小尺寸模型将陆续开源发布,Qwen4-Max目前为闭源模型。
媒体评价
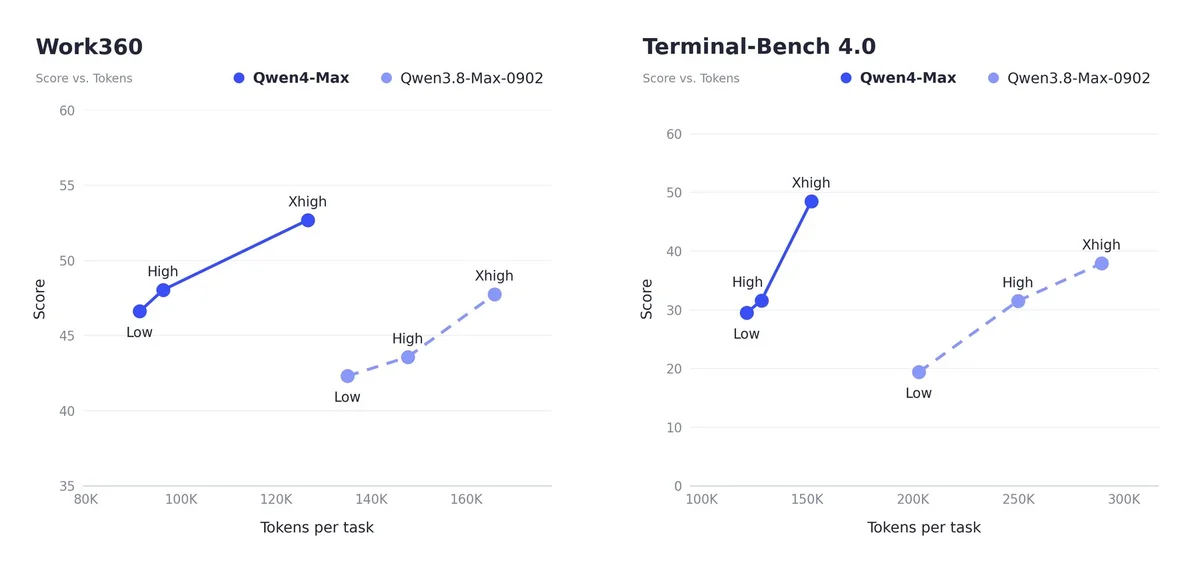
据〈The Decoder〉报道,Qwen4-Max在Work360工业任务基准测试中,Token使用量仅为前代的四分之一到三分之一,得分从47.74提升至52.69,同时成本下降62%。在Terminal-Bench 4.0中,Token使用量减半,得分提升至48.7。
〈heise online〉指出,Qwen4-Max在Vals Index(专业任务评估)中以63.20%的得分略微领先于Kimi K3.1 Pro(62.52%),但在综合智能指数上仍落后于Claude Fable 5.2等西方旗舰模型。其优势在于极高的成本效率,缓存命中成本极低,适合高频调用的工作流。
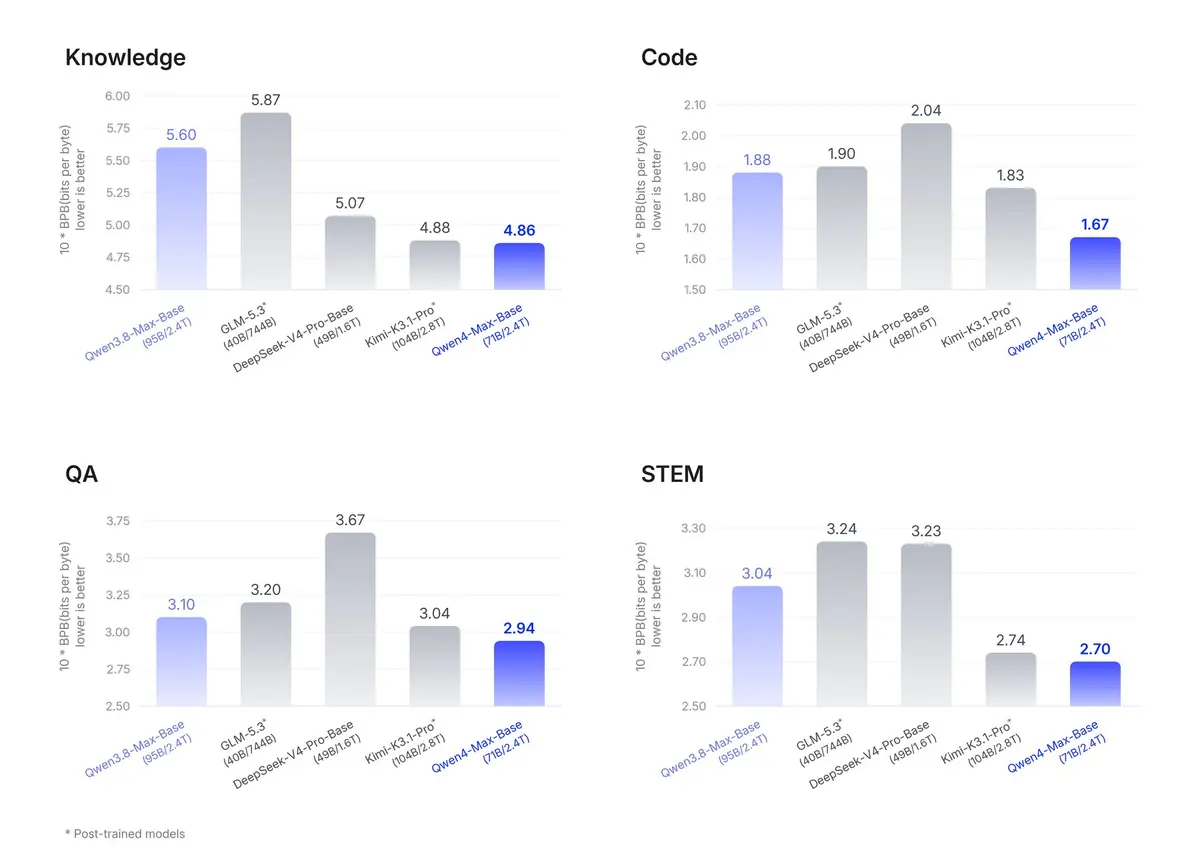
〈量子位〉提到,在CodeArena全球盲测中,Qwen4-Max前端编程位列全球第6,介于GPT-6-Astra和Claude Fable 5.1之间。在智能体能力上,其Live Delivery机制允许用户在使用中修改结果,例如在14次迭代中构建出一个包含3D动画的科普网站,人机协作流畅度显著提升。
个人工作室如何用Qwen4-Max省钱并提升效率?
对于独立创作者和家庭工作室,Qwen4-Max最大的价值在于“长周期任务”的成本可控性。以往使用AI进行复杂代码生成、长篇文档处理或3D模型迭代时,Token消耗往往呈指数级增长。Qwen4-Max通过混合架构将单任务平均成本降低60%,且缓存命中价格极低(约0.5元/百万Token),这意味着你可以更频繁地让AI重试、优化或生成多个版本,而无需担心账单爆炸。
其“Live Delivery”功能特别适合非专业开发者。例如,你想做一个简单的互动网页或3D打印模型,AI生成初版后,你可以随时介入调整细节,而不是等到最后才看到结果。结合其对Blender和Unity的原生支持,你可以用自然语言描述需求,让AI完成从逻辑编写到3D资产生成的全流程,大幅降低独立游戏或3D打印作品的制作门槛。
对于拥有NAS或小型GPU集群的用户,Qwen4-Max的高效率意味着你可以在本地或边缘设备上更经济地部署Agent工作流,处理数据标注、文件整理或自动化报告生成。虽然其绝对性能略逊于Claude Fable 5.2等顶级模型,但在性价比和中文语境下的专业任务(如金融、法律、编程)表现上,它提供了极具吸引力的替代方案,尤其适合对成本敏感且需要高频调用的个人用户。
参考来源
- The Decoder:Alibaba's Qwen4-Max takes on Opus 5.5, GPT-6, and Kimi K3.1 Pro at much lower prices(2026-11-16)
- heise online:Qwen4-Max: Alibabas Spitzenmodell legt deutlich zu und wird zugleich günstiger(2026-11-16)
- 量子位:阿里正式发布Qwen4,智能体及编程能力进阶,迈向真实全场景(2026-11-16)
- GIGAZINE:「Qwen4-Max」が登場、一部テストでClaude Opus 5.5に勝利し小型オープンモデルも後日公開予定(2026-11-16)


